Как установить Ollama и запустить нейросеть на своём ПК инструкция для Windows, выбор моделей и требования к видеокарте
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API. Пошаговые команды, сравнение Gemma 4, Qwen, DeepSeek и GPT-OSS, требования к VRAM, настройка CUDA и реальные ограничения ПК с RTX 4080 SUPER и 64 ГБ оперативной памяти.
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API.
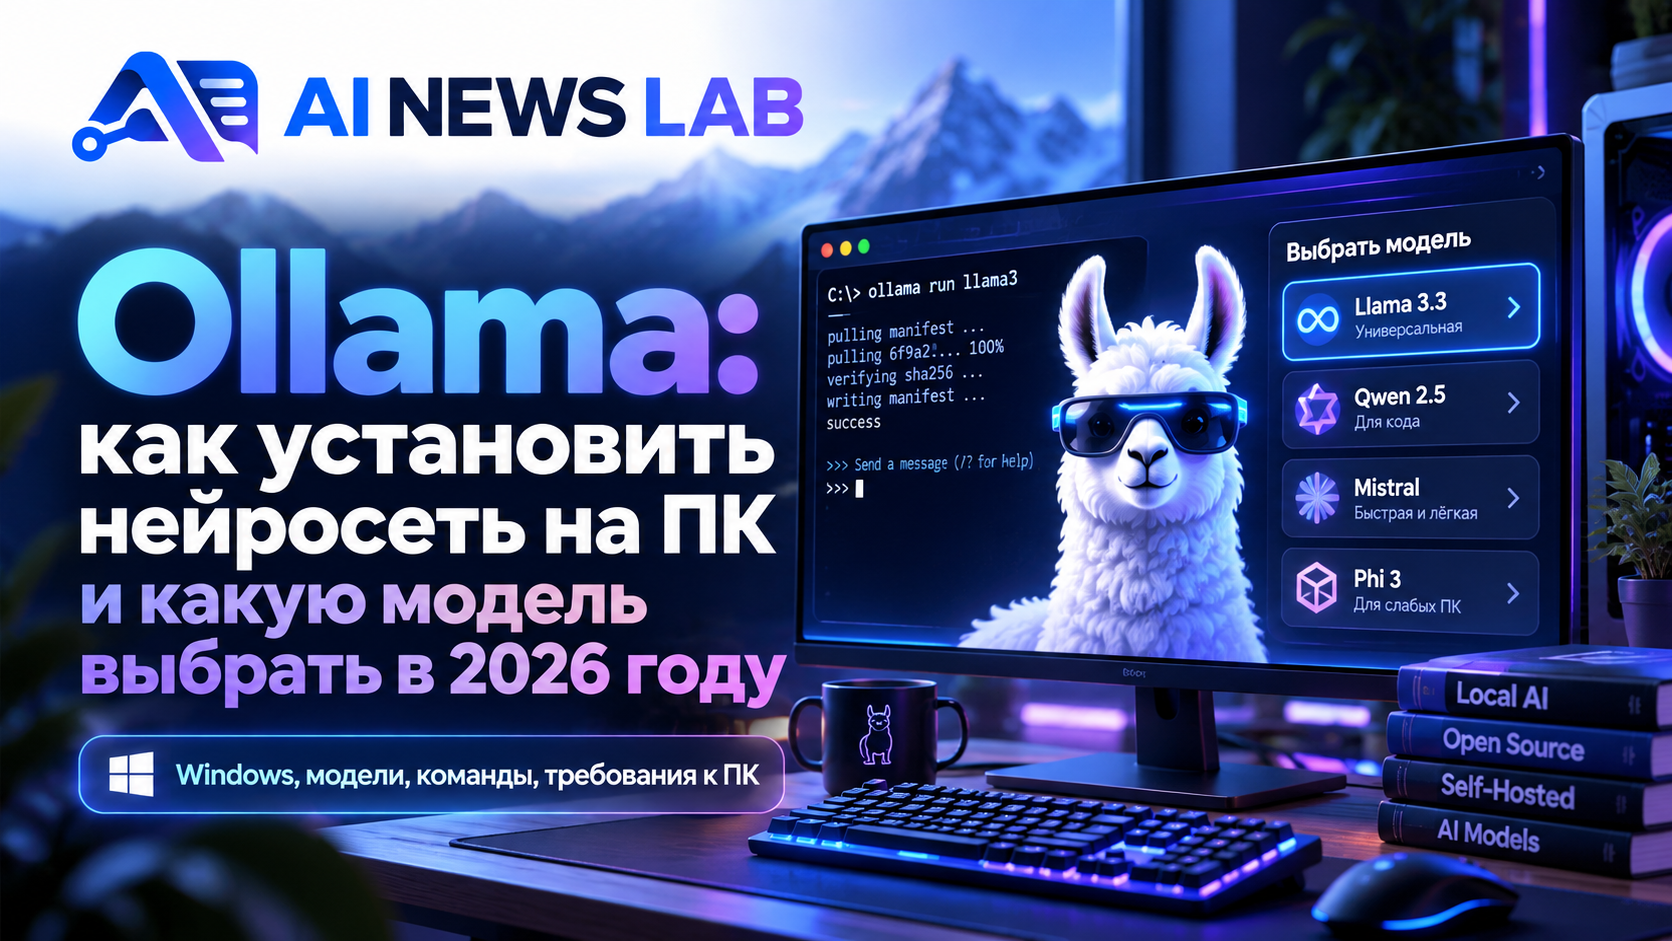
Установить нейросеть на собственный компьютер можно бесплатно через Ollama. Скачайте программу с официального сайта https://ollama.com/download, установите её на Windows, откройте PowerShell и выполните команду `ollama run qwen3.5:9b`. Ollama загрузит модель и запустит чат непосредственно на компьютере. Для работы с локальной моделью не нужны платный API-ключ и постоянное интернет-соединение после первоначальной загрузки.
На ПК с NVIDIA RTX 4080 SUPER (16 ГБ видеопамяти) и 64 ГБ оперативной памяти можно комфортно начать с Qwen 3.5 9B, Gemma 4 12B, DeepSeek-R1 14B и GPT-OSS 20B. Более крупные модели тоже можно попробовать, но часть вычислений может перейти с видеокарты на процессор, заметно снизив скорость.
Ниже — полноценная инструкция для Windows 10 и Windows 11: от первой установки до выбора моделей, настройки памяти, работы с документами и подключения локального ИИ к Python-приложениям.
Коротко какую нейросеть установить на компьютер
Для первого знакомства не нужна самая большая модель. Начните с той, которая помещается в видеопамять и решает вашу задачу.
Задача
Что попробовать
Команда
Общение на русском
Qwen 3.5 9B
ollama run qwen3.5:9b
Работа с текстом и изображениями
Gemma 4 12B
ollama run gemma4:12b
Логика и рассуждения
DeepSeek-R1 14B
ollama run deepseek-r1:14b
Программирование
Qwen 2.5 Coder 14B
ollama run qwen2.5-coder:14b
Сложные текстовые задачи
GPT-OSS 20B
ollama run gpt-oss:20b
Быстрая модель для слабого ПК
Llama 3.2 3B
ollama run llama3.2:3b
Работа с изображениями
Gemma 3 4B
ollama run gemma3:4b
Поиск по локальным документам
nomic-embed-text
ollama pull nomic-embed-text
Это варианты для разных задач, а не рейтинг качества моделей. Скорость и точность зависят от конкретного компьютера, квантования, контекста и условий проверки.
Что такое Ollama и как она работает
Ollama — программа для загрузки и запуска языковых моделей на собственном компьютере.
Она предоставляет терминальный интерфейс, локальный HTTP API и возможность подключать нейросети к другим приложениям.
После установки пользователь получает сервер, который обычно доступен по адресу:
`http://localhost:11434`
К нему могут обращаться локальные Python-скрипты, интерфейсы чата и инструменты программирования.
В отличие от обычного облачного сервиса, локальная модель выполняет вычисления на вашем оборудовании.
Это позволяет работать с текстом без отправки содержимого запроса стороннему API, если используются именно локальные модели и не подключены внешние инструменты.
Однако Ollama также поддерживает облачные модели. Поэтому само наличие программы на компьютере не гарантирует, что выбранная модель работает локально. Всегда проверяйте её тип и настройки.
Ollama бесплатная или платная?
Программа Ollama доступна бесплатно.
Локальные модели можно скачивать и запускать без оплаты запросов по токенам.
Но это не означает отсутствия расходов вообще: компьютер потребляет электроэнергию, модели занимают место на диске, а коммерческое использование отдельных весов регулируется соответствующими лицензиями.
Облачные функции могут иметь другие условия.
Нужен ли интернет?
Для загрузки установщика и моделей — да.
После загрузки модель может работать локально без интернета.
Для проверки можно отключить сетевое подключение и отправить простой запрос уже скачанной модели.
Если ответ приходит, локальный запуск работает.
При использовании веб-поиска, облачных моделей и внешних API интернет потребуется снова.
Какой компьютер нужен для локальных нейросетей
Требования зависят в первую очередь от размера модели и объёма доступной памяти.
Условные обозначения 3B, 8B, 14B и 32B обычно относятся к числу параметров модели в миллиардах.
Но количество параметров — не единственный показатель нагрузки.
Крупная модель с сильным сжатием иногда занимает меньше памяти, чем можно ожидать по её названию.
Примерные классы компьютеров
Оборудование
Практический ориентир
Без дискретной видеокарты, 8–16 ГБ RAM
Небольшие модели 1–3B
GPU 6 ГБ, RAM 16 ГБ
Многие модели 3–7B в подходящем квантовании
GPU 8 ГБ, RAM 16–32 ГБ
Модели 7–9B; некоторые крупнее при компромиссах
GPU 12 ГБ, RAM 32 ГБ
Часто удобны 8–14B
GPU 16 ГБ, RAM 32–64 ГБ
9–20B в подходящих форматах
GPU 24 ГБ, RAM 64 ГБ
Более широкая группа 20–32B
GPU 48 ГБ и больше
Крупные модели, длинный контекст и более высокая параллельная нагрузка
Эти оценки не являются гарантированными системными требованиями всех моделей.
Особенно сильно на расход памяти влияет длина контекста.
Почему видеопамять важнее мощности процессора
Если модель целиком размещается в VRAM, вычисления обычно выполняются существенно быстрее.
Когда памяти видеокарты недостаточно, Ollama может использовать системную RAM и процессор.
Это расширяет набор запускаемых моделей, но снижает производительность.
Поэтому RTX 4080 SUPER с 16 ГБ VRAM часто будет удобнее для локального ИИ, чем компьютер с очень мощным процессором, но без дискретного GPU.
Разбор компьютера с RTX 4080 SUPER и Core i9-14900KS
Рассмотрим следующую конфигурацию.
Комплектующее
Характеристика
Процессор
Intel Core i9-14900KS
Видеокарта
GIGABYTE GeForce RTX 4080 SUPER AERO OC
Видеопамять
16 ГБ GDDR6X
Оперативная память
64 ГБ DDR5, по указанной комплектации
Материнская плата
ASUS ROG STRIX Z790-E GAMING WIFI
Накопители
2 × ADATA XPG GAMMIX S70 Blade по 1 ТБ
Охлаждение
MSI MEG CORELIQUID S360
Блок питания
DeepCool PX1200G 1200 Вт
Операционная система
Windows 10
Здесь есть нюанс по оперативной памяти: название указанного комплекта ADATA содержит обозначение 32 ГБ. Если установлены два таких комплекта, общий объём составляет 64 ГБ. Фактический объём лучше подтвердить через диспетчер задач Windows.
Что в этой сборке особенно хорошо для Ollama
RTX 4080 SUPER поддерживает ускорение вычислений NVIDIA CUDA.
64 ГБ оперативной памяти позволяют запускать часть более крупных моделей с переносом весов в системную память.
Быстрые NVMe-накопители удобны для хранения нескольких моделей, размер каждой из которых может достигать десятков гигабайт.
Core i9-14900KS помогает при обработке данных, подготовке запросов и частичном выполнении модели на CPU.
Однако дорогой процессор не устраняет ограничение в 16 ГБ видеопамяти.
Какие модели я бы установил на такой ПК
Первая — Qwen 3.5 9B. Хороший кандидат для основного локального чата, русскоязычных текстов и повседневных задач.
Вторая — Gemma 4 12B. Подходит для проверки текстовых и мультимодальных сценариев.
Третья — GPT-OSS 20B. Интересна для рассуждений и сложных инструкций. Размер опубликованного пакета около 14 ГБ, поэтому при достаточном свободном объёме VRAM модель может работать с GPU-ускорением, но увеличение контекста способно привести к нехватке памяти.
Четвёртая — DeepSeek-R1 14B. Полезный вариант для сравнительных тестов логики и пошагового решения задач.
Для программирования отдельно имеет смысл держать Qwen 2.5 Coder 14B.
Это рекомендуемый стартовый комплект, а не результат проведённого на указанном ПК бенчмарка.
Какие модели поместятся в RTX 4080 SUPER 16 ГБ
Размер скачиваемого файла не равен всему объёму памяти, необходимому для работы.
Помимо весов модели используется KV-cache, служебная память и другие буферы.
Модель
Размер пакета в каталоге Ollama
Оценка для RTX 4080 SUPER
Qwen 3.5 9B
около 6,6–7,6 ГБ
Хороший вариант
Gemma 4 12B
около 7,7–8 ГБ
Хороший вариант
DeepSeek-R1 14B
около 9 ГБ
Обычно подходит
GPT-OSS 20B
около 14 ГБ
Близко к границе VRAM
Gemma 4 26B
около 16–19 ГБ
Может потребовать RAM или другого квантования
Qwen 3.5 27B
около 17–20 ГБ
Вероятна частичная выгрузка в RAM
DeepSeek-R1 32B
около 20 ГБ
Не помещается целиком в 16 ГБ VRAM в указанном варианте
DeepSeek-R1 70B
около 43 ГБ
Запуск возможен только с существенными компромиссами
GPT-OSS 120B
около 65 ГБ
Не подходит для комфортного локального запуска на этой сборке
Нужно отдельно учитывать, что опубликованные семейства могут содержать несколько квантований с разными требованиями к памяти.
Для рабочего режима предпочтительно выбирать модель, которая целиком помещается на GPU с запасом под контекст.
Как установить Ollama на Windows 10 и Windows 11
Официальные требования Ollama для Windows включают Windows 10 версии 22H2 или новее и подходящий драйвер NVIDIA.
Шаг 1. Проверьте версию Windows
Нажмите Win + R и введите:
`winver`
Проверьте, что Windows соответствует требованиям установленной версии Ollama.
Если система давно не обновлялась, сначала установите необходимые обновления безопасности.
Шаг 2. Проверьте драйвер NVIDIA
Откройте PowerShell и выполните:
nvidia-smiКоманда должна показать видеокарту, версию драйвера и сведения об использовании видеопамяти.
Если Windows не находит `nvidia-smi`, проверьте установку драйвера NVIDIA и путь к программе.
Для RTX 4080 SUPER важно установить поддерживаемый актуальный драйвер.
Шаг 3. Скачайте Ollama
Откройте официальный сайт:
Выберите установщик для Windows и запустите его.
Не скачивайте программу с неизвестных файловых обменников.
После установки Ollama обычно работает в фоне, а команда `ollama` становится доступна в PowerShell и CMD.
Шаг 4. Проверьте установку
Откройте новый PowerShell:
ollama --versionЗатем:
ollama listЕсли Ollama установлена, появится информация о версии и список локальных моделей.
Список может быть пустым до первой загрузки.
Шаг 5. Установите первую модель
Для начала рекомендую Qwen 3.5 9B:
ollama pull qwen3.5:9bДождитесь завершения загрузки.
Затем запустите:
ollama run qwen3.5:9bНапишите:
«Объясни простыми словами, чем локальная нейросеть отличается от облачной. Ответь по-русски и приведи три примера».
После ответа модель готова к использованию.
Чтобы выйти из интерактивного чата, используйте:
`/bye`
Как управлять моделями Ollama через терминал
Большинство повседневных операций выполняется несколькими командами.
Команда
Назначение
ollama list
Показать скачанные модели
ollama pull MODEL
Скачать модель
ollama run MODEL
Запустить чат
ollama show MODEL
Посмотреть сведения о модели
ollama ps
Показать загруженные в память модели
ollama stop MODEL
Выгрузить работающую модель
ollama rm MODEL
Удалить локальную модель
ollama cp SOURCE TARGET
Создать копию модели под другим именем
ollama serve
Запустить локальный сервер, если он ещё не работает
Вместо MODEL указывается конкретный тег, например `gemma4:12b`.
Как узнать, работает ли нейросеть на видеокарте
Сначала запустите модель.
Затем во втором окне PowerShell выполните:
ollama psПосмотрите столбец PROCESSOR.
Если указано `100% GPU`, модель работает на видеокарте.
Если отображается разделение CPU/GPU, часть вычислений выполняется с использованием системной памяти и процессора.
Дополнительно проверьте:
nvidia-smiУвеличение занятой VRAM при запуске модели подтверждает использование видеопамяти.
Как настроить контекст и не переполнить видеопамять
Контекст определяет, сколько токенов модель способна учитывать при обработке запроса.
Большой контекст полезен для длинных документов, истории диалога и анализа программных проектов.
Однако увеличение контекста требует дополнительной памяти.
В актуальной документации Ollama для GPU с менее чем 24 ГБ VRAM указан стандартный контекст 4 096 токенов, если пользователь не изменил настройку.
Для RTX 4080 SUPER это означает, что длинный контекст лучше включать осознанно.
Практические ориентиры
Для короткого чата можно начать с 4 096 токенов.
Для работы со статьями попробовать 8 192.
Для анализа более крупных документов — 16 384, если позволяет VRAM.
Для программирования и больших проектов иногда требуется 32 768 токенов и больше, но на 16-гигабайтной видеокарте это может заметно повлиять на скорость и доступную память.
Максимальный контекст, указанный в описании модели, не означает, что компьютер способен работать с ним целиком на GPU.
Изменение контекста внутри чата
Для поддерживаемых версий CLI можно использовать:
/set parameter num_ctx 8192Затем продолжить разговор и проверить расход памяти.
В приложении Ollama также предусмотрена настройка контекста через интерфейс.
Если вы используете API, параметр контекста можно передавать в настройках запроса.
Как перенести модели Ollama на другой SSD
По умолчанию скачанные модели занимают место в пользовательском каталоге.
Если моделей много, системный диск может быстро заполниться.
В Windows Ollama поддерживает переменную окружения `OLLAMA_MODELS`.
Предположим, вы хотите хранить модели в:
`D:\Ollama\Models`
Сначала создайте каталог:
New-Item -ItemType Directory -Force "D:\Ollama\Models"Затем установите переменную окружения для пользователя:
[Environment]::SetEnvironmentVariable("OLLAMA_MODELS", "D:\Ollama\Models", "User")Полностью закройте Ollama через значок в системном трее и запустите её заново.
После этого новые модели должны использовать заданный каталог.
Если модели уже скачаны, перед очисткой старой папки необходимо отдельно перенести содержимое хранилища и проверить, что Ollama корректно видит файлы.
Не удаляйте старые данные до успешной проверки.
Как установить несколько моделей и сравнить ответы
Скачайте:
ollama pull qwen3.5:9b
ollama pull gemma4:12b
ollama pull deepseek-r1:14b
ollama pull gpt-oss:20b
Каждая команда скачивает отдельный пакет.
Лучше начать с двух моделей, если на диске ограничено свободное место.
Затем задайте одинаковый вопрос:
ollama run qwen3.5:9bИ повторите его в другой модели:
ollama run gemma4:12bСравнивайте не только стиль ответа.
Оценивайте фактическую точность, соблюдение ограничений, полноту, скорость и количество ошибок.
Для программирования обязательно проверяйте создаваемый код.
Как использовать Ollama для написания статей и SEO
Локальная модель может помогать создавать планы материалов, анализировать предоставленную семантику, структурировать таблицы и находить логические пробелы в тексте.
Но без реальной выдачи Яндекса и Google она не знает точных позиций, частотностей и текущих конкурентов.
Пример полноценного запроса
«Ты редактор технического издания. Проанализируй предоставленную структуру статьи об установке Python. Проверь последовательность действий, найди неясные инструкции, устаревшие команды и повторяющиеся объяснения.
Не придумывай версии программ, результаты тестов и характеристики компьютеров.
Для каждой проблемы предложи конкретное исправление. Сохраняй естественный русский язык, избегай рекламных формулировок и повторений.
В конце подготовь короткий чек-лист проверки работоспособности инструкции».
Такой запрос полезен именно как редакторский инструмент.
Финальную проверку команд и фактов должен выполнять человек.
Для других сценариев можно использовать подборку промптов для ChatGPT на русском, адаптируя запросы под локальные модели.
Как подключить Ollama к Python
Локальный сервер Ollama предоставляет HTTP API.
Это удобно для скриптов автоматизации, обработки документов и собственных приложений.
Пример без дополнительных библиотек
Если установлен Python, создайте файл `local_ai.py`:
import json
from urllib.request import Request, urlopen

payload = {
    "model": "qwen3.5:9b",
    "messages": [
        {
            "role": "user",
            "content": "Напиши пять рекомендаций по защите Windows."
        }
    ],
    "stream": False
}

request = Request(
    "http://localhost:11434/api/chat",
    data=json.dumps(payload).encode("utf-8"),
    headers={"Content-Type": "application/json"},
    method="POST"
)

with urlopen(request, timeout=180) as response:
    result = json.load(response)

print(result["message"]["content"])
Выполните:
python local_ai.pyЕсли Ollama запущена и модель загружена, скрипт выведет ответ.
Для облачного API такая схема потребовала бы соответствующих учётных данных и условий тарификации. Здесь используется локальный сервер.
Как подключить удобный интерфейс вместо терминала
Работать с нейросетью можно не только через PowerShell.
Ollama поддерживает графическое приложение и интеграции со сторонними интерфейсами.
Один из известных вариантов — Open WebUI.
Он предоставляет привычный чат в браузере, историю разговоров и возможности работы с локальными моделями.
Официальный проект:
https://github.com/open-webui/open-webui
Перед установкой проверьте актуальные требования, способ запуска и настройки безопасности.
Не открывайте интерфейс или порт Ollama в интернет без аутентификации и дополнительных мер защиты.
Для первого знакомства вполне достаточно встроенного интерфейса Ollama и терминала.
Как проверить локальный API через PowerShell
После запуска Ollama выполните:
Invoke-RestMethod -Uri "http://localhost:11434/api/tags"Команда должна вернуть сведения о локально доступных моделях.
Теперь отправим тестовое сообщение:
$body = @{
    model = "qwen3.5:9b"
    prompt = "Объясни, что такое Ollama, двумя предложениями."
    stream = $false
} | ConvertTo-Json

$result = Invoke-RestMethod `
    -Uri "http://localhost:11434/api/generate" `
    -Method Post `
    -ContentType "application/json" `
    -Body $body

$result.response
Это позволяет использовать локальную нейросеть в собственных программах без прямого обращения к облачному API.
Как сделать локальную нейросеть полезнее: практические настройки
Не держите сразу несколько больших моделей в памяти
На видеокарте с 16 ГБ VRAM лучше загружать одну крупную модель, если одновременная работа нескольких не требуется.
Проверяйте:
ollama psИ выгружайте ненужные модели:
ollama stop qwen3.5:9bНе начинайте с максимального контекста
Контекст в десятки тысяч токенов может занять значительный объём памяти.
Начните с умеренного значения и увеличивайте его только под реальные задачи.
Используйте маленькую модель для простых операций
Для классификации коротких текстов или извлечения простых полей большая модель может быть избыточной.
Сравните небольшой вариант и крупную модель на одинаковом наборе заданий.
Не доверяйте ответам без проверки
Локальный запуск не делает информацию автоматически точной.
Модель может ошибаться в датах, формулах, ссылках и технических инструкциях.
Следите за температурой и стабильностью
Длительные вычисления нагружают GPU и систему охлаждения.
Проверяйте температуру, потребление памяти и стабильность драйвера через средства мониторинга.
Для Intel Core i9-14900KS также важно использовать актуальный BIOS и рекомендации производителя материнской платы по настройкам питания и стабильности.
Что делать, если Ollama работает медленно
Сначала выполните:
ollama psЕсли модель частично находится на CPU, причина может заключаться в нехватке VRAM.
Попробуйте выбрать меньшую модель или квантование.
Если модель находится полностью на GPU, проверьте длину контекста, число параллельных запросов и фоновые приложения.
Закройте программы, активно использующие видеопамять, и повторите тест.
Также проверьте, не запущено ли одновременно несколько тяжёлых моделей.
Частые ошибки Ollama и способы исправления
Проблема
Возможная причина
Что проверить
ollama
не найдена
Программа не установлена или PATH не обновлён
Переустановить, открыть новый терминал
Ошибка подключения к localhost
Сервер Ollama не работает
Запустить приложение
Модель не найдена
Неверный тег или модель не скачана
ollama list
,
ollama pull
Очень медленный ответ
Часть модели работает на CPU
ollama ps
Нехватка видеопамяти
Слишком крупная модель или контекст
Уменьшить модель или контекст
Нет доступа к загрузке
Проблемы сети или сервера моделей
Проверить интернет и повторить загрузку
Не хватает места на диске
Большие веса моделей
Изменить
OLLAMA_MODELS
Приложение зависает
Драйвер, ресурсы или несовместимость
Обновить Ollama, изучить журналы
На Windows журналы приложения обычно находятся в `%LOCALAPPDATA%\Ollama`.
Можно ли использовать локальные нейросети для бизнеса
Да, если лицензия конкретной модели допускает выбранный способ использования.
Например, локальная нейросеть может помогать классифицировать обращения, искать информацию в документах, готовить черновики писем и автоматизировать повторяющиеся операции.
Преимущество такого подхода — возможность самостоятельно контролировать инфраструктуру.
Но вместе с этим появляются обязанности по обслуживанию, защите данных и проверке результатов.
Для компании важно предусмотреть ограничения доступа, резервное копирование и журналирование действий автоматизации.
Подробнее о сценариях можно прочитать в материале «Нейросети для бизнеса: инструменты и примеры применения».
Ollama против облачных ChatGPT, Claude и Gemini
Локальный и облачный подходы решают разные задачи.
Критерий
Ollama с локальной моделью
Облачная нейросеть
Обработка текста
На собственном ПК
На серверах провайдера
Интернет после установки
Для локального чата необязателен
Обычно необходим
Плата за запросы
Нет для локального запуска
Зависит от тарифа
Производительность
Ограничена собственным железом
Зависит от сервиса
Обновление моделей
Пользователь управляет загрузкой
Разработчик сервиса
Конфиденциальность
Больше контроля при корректной настройке
Зависит от условий провайдера
Размер доступной модели
Ограничен памятью и вычислениями ПК
Может быть значительно больше
Для задач, где особенно важны скорость запуска и удобство, облачный сервис часто проще.
Для автоматизации, экспериментов и обработки локальных данных Ollama может оказаться практичнее.
Частые вопросы
Можно ли установить Ollama на Windows 10?
Да. Актуальная документация Ollama указывает поддержку Windows 10 версии 22H2 или новее при выполнении остальных требований.
Какую нейросеть установить на RTX 4080 SUPER?
Для начала рекомендую Qwen 3.5 9B, Gemma 4 12B и DeepSeek-R1 14B. GPT-OSS 20B также интересна, но при большом контексте может потребовать дополнительной памяти.
Хватит ли 16 ГБ видеопамяти для модели 32B?
Это зависит от квантования и длины контекста. Некоторые варианты могут частично использовать системную RAM. Полностью разместить модель размером около 20 ГБ в 16 ГБ VRAM нельзя.
Можно ли запускать нейросети без видеокарты?
Да, небольшие модели способны работать на процессоре. Но скорость часто оказывается значительно ниже, особенно для сложных задач.
Нужна ли регистрация для Ollama?
Для скачивания и локального запуска поддерживаемых моделей обычная регистрация в облачном сервисе не требуется. Для облачных функций могут действовать отдельные условия.
Работает ли Ollama без интернета?
Локальные модели после загрузки могут работать без подключения к сети. Интернет нужен для получения обновлений, новых моделей и внешних сервисов.
Можно ли писать программы с помощью Ollama?
Да. Можно использовать модели, ориентированные на код, например Qwen 2.5 Coder, и подключать их к инструментам разработки.
Какая локальная модель лучше для русского языка?
Зависит от типа задачи. Qwen 3.5 9B — разумная отправная точка для сравнения. Но для выбора нужно проверить несколько моделей на собственных русскоязычных заданиях.
Можно ли запустить DeepSeek-R1 70B на 64 ГБ оперативной памяти?
Теоретически подходящее квантование может использовать системную память, но необходимо учитывать дополнительные накладные расходы, контекст и память операционной системы. На RTX 4080 SUPER 16 ГБ такой запуск не будет столь же быстрым, как работа модели, полностью помещающейся на GPU.
Что лучше: Ollama или LM Studio?
Оба инструмента позволяют работать с локальными моделями. Ollama особенно удобна для терминала, локального API и автоматизации, а LM Studio часто выбирают за графический интерфейс. Конкретный выбор зависит от сценария.
Итог: с чего начать владельцу мощного ПК
Для системы с RTX 4080 SUPER 16 ГБ и 64 ГБ RAM оптимально сначала установить Ollama, проверить работу CUDA и скачать две модели — Qwen 3.5 9B и Gemma 4 12B.
Затем стоит сравнить их на собственных задачах: русский текст, программирование, анализ документов и соблюдение инструкций.
После этого можно попробовать GPT-OSS 20B и более крупные варианты с учётом ограничений видеопамяти.
Не обязательно скачивать десятки моделей сразу. Достаточно подобрать несколько, которые действительно дают нужное качество и работают с приемлемой скоростью.
Главное преимущество локальной нейросети — контроль над средой выполнения и отсутствие оплаты каждого запроса. Но качество зависит от выбранной модели, а скорость — от доступной памяти и настроек компьютера.
*Инструкция подготовлена 11 октября 2026 года на основе официальной документации Ollama и опубликованных характеристик моделей. Приведённая аппаратная конфигурация используется как пример расчёта совместимости. Реальные измерения скорости генерации и расхода видеопамяти на этом ПК проводились.*
Частые вопросы
Ollama бесплатная или платная?
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API. Пошаговые команды, сравнение Gemma 4, Qwen, DeepSeek и GPT-OSS, требования к VRAM, настройка CUDA и реальные ограничения ПК с RTX 4080 S
Нужен ли интернет?
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API. Пошаговые команды, сравнение Gemma 4, Qwen, DeepSeek и GPT-OSS, требования к VRAM, настройка CUDA и реальные ограничения ПК с RTX 4080 S
Можно ли установить Ollama на Windows 10?
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API. Пошаговые команды, сравнение Gemma 4, Qwen, DeepSeek и GPT-OSS, требования к VRAM, настройка CUDA и реальные ограничения ПК с RTX 4080 S
Какую нейросеть установить на RTX 4080 SUPER?
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API. Пошаговые команды, сравнение Gemma 4, Qwen, DeepSeek и GPT-OSS, требования к VRAM, настройка CUDA и реальные ограничения ПК с RTX 4080 S
Хватит ли 16 ГБ видеопамяти для модели 32B?
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API. Пошаговые команды, сравнение Gemma 4, Qwen, DeepSeek и GPT-OSS, требования к VRAM, настройка CUDA и реальные ограничения ПК с RTX 4080 S
Можно ли запускать нейросети без видеокарты?
Как бесплатно установить Ollama на Windows и запускать нейросети без облачного API. Пошаговые команды, сравнение Gemma 4, Qwen, DeepSeek и GPT-OSS, требования к VRAM, настройка CUDA и реальные ограничения ПК с RTX 4080 S